Tutorial Praktis llama.cpp: Optimasi Parameter (Threads, Context, dan Temperature) untuk Performa Maksimal
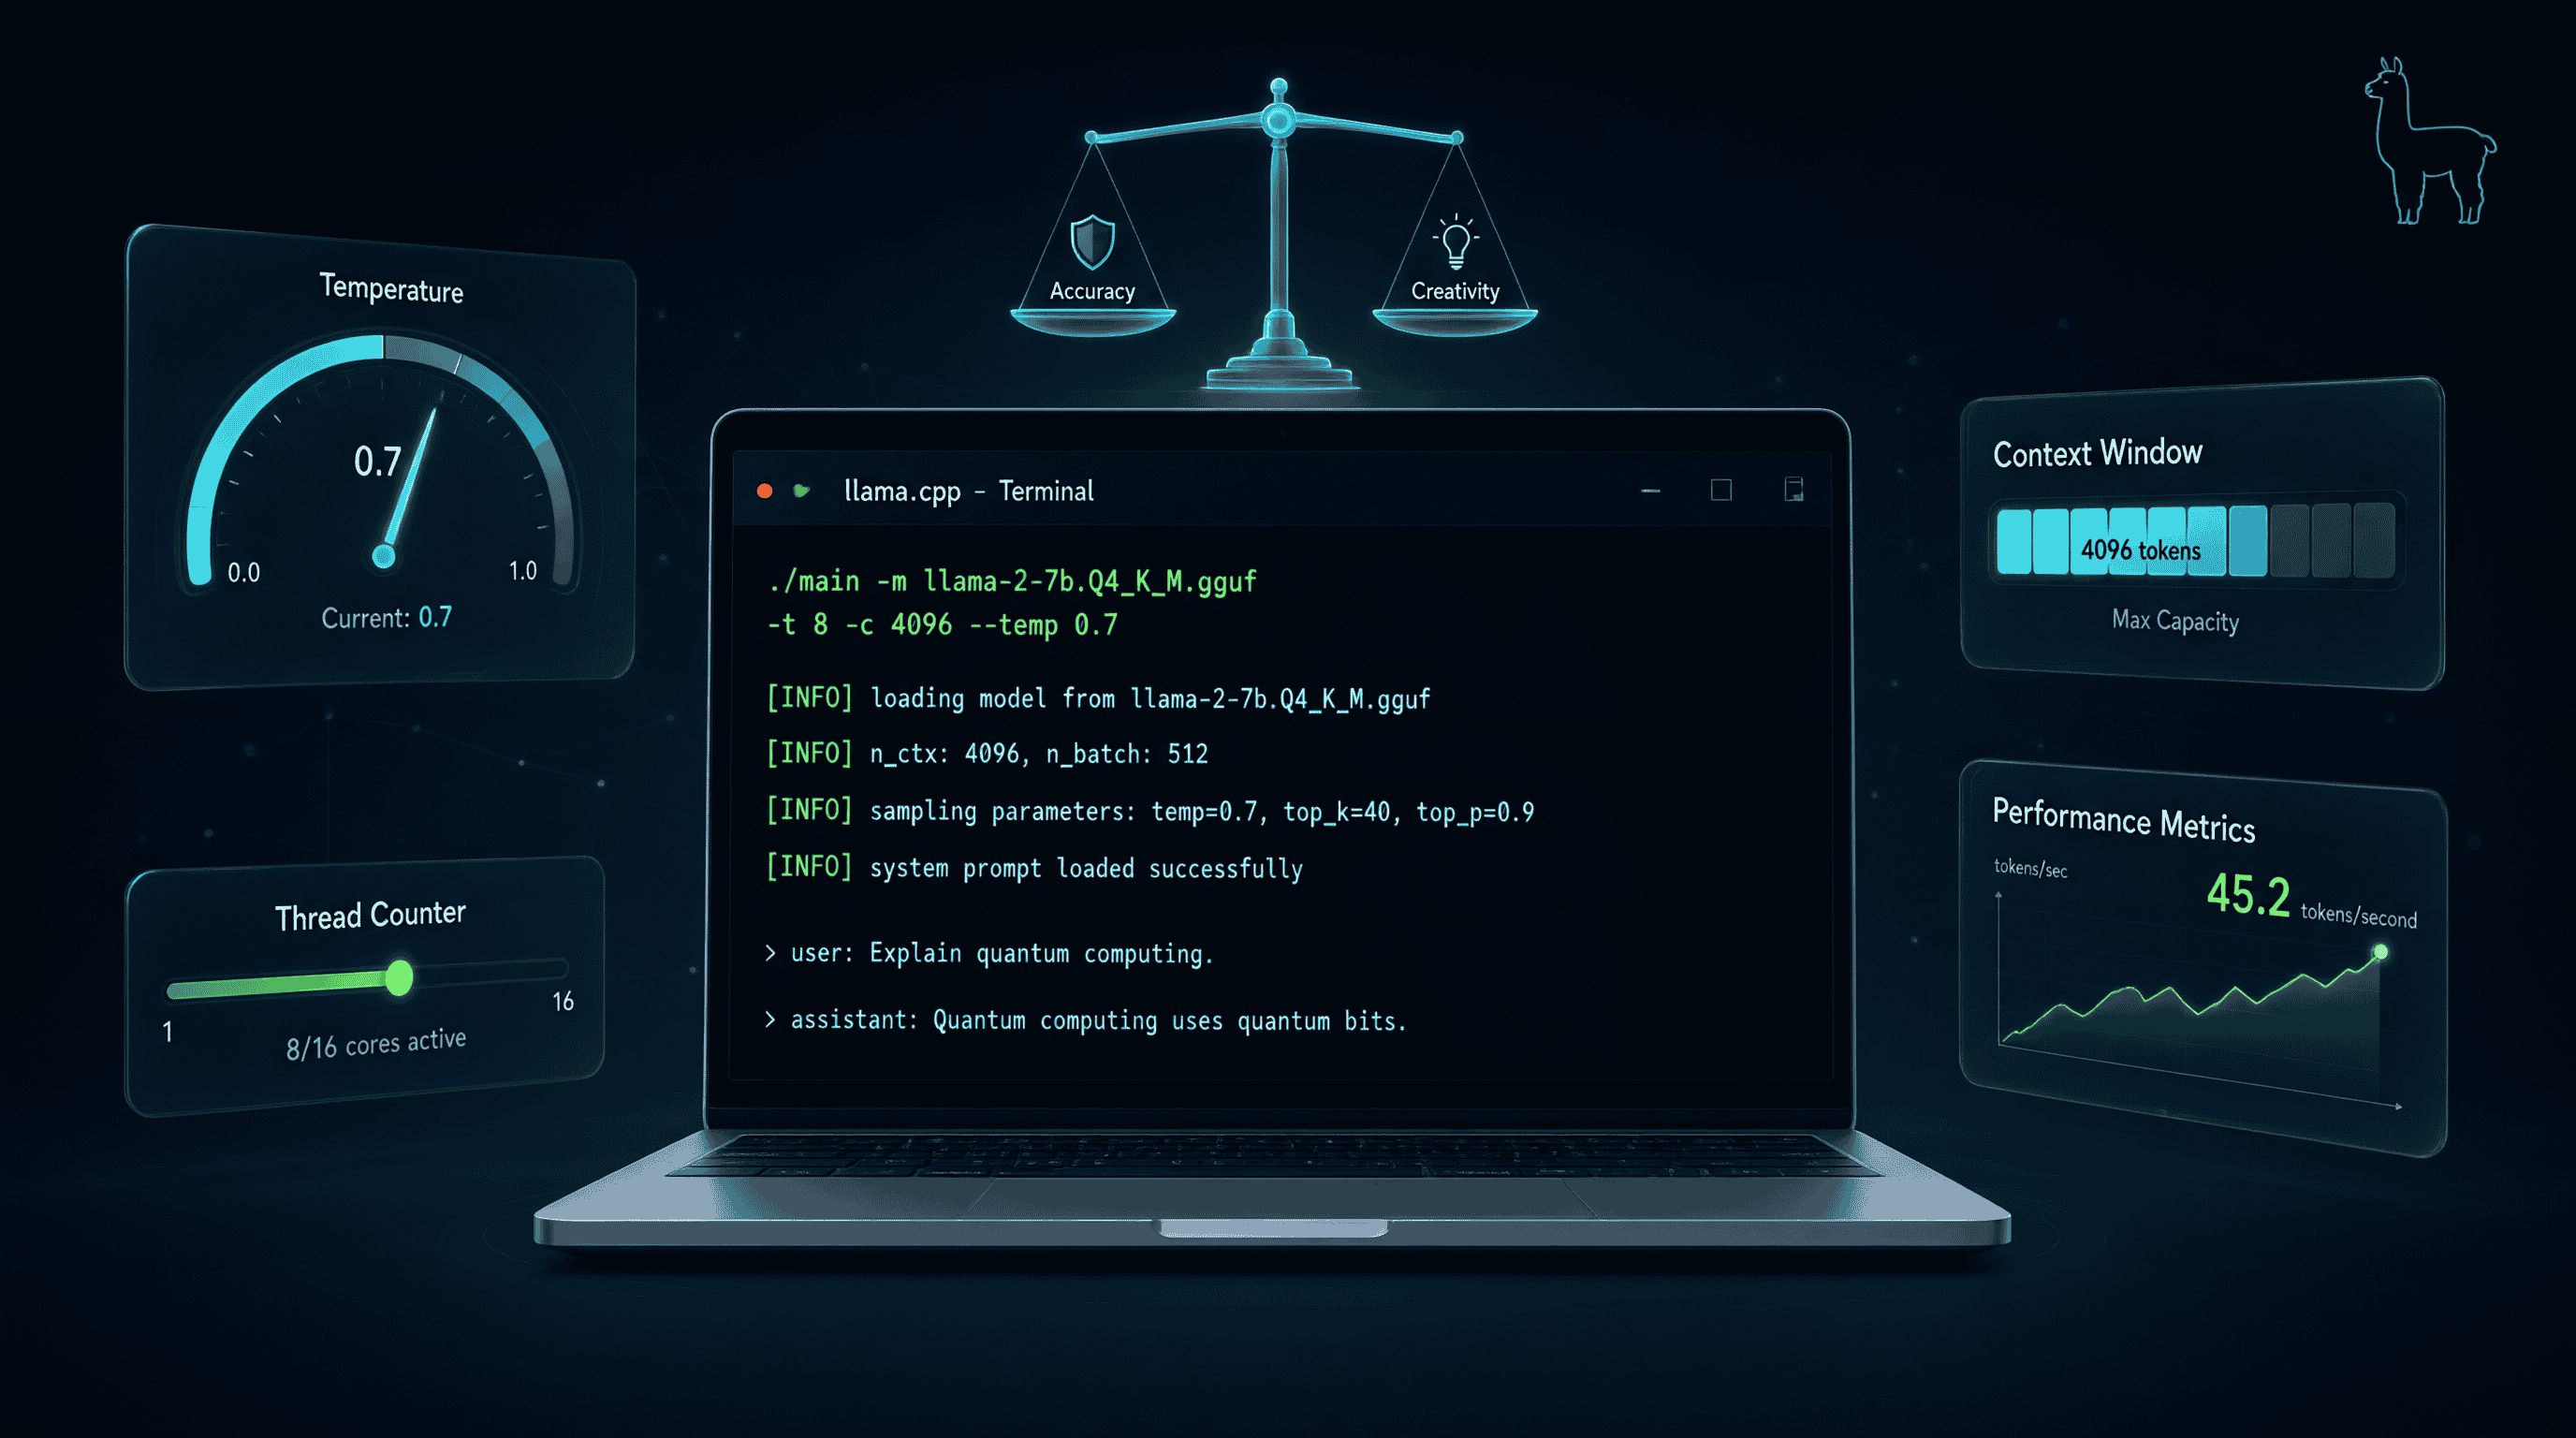
Made Artha | Web Developer & Academic Researcher | Artha.web.id | [email protected]
Abstract— Artikel ini menyajikan panduan praktis (hands-on) untuk mengoptimalkan parameter inferensi pada library llama.cpp. Pengaturan default seringkali tidak memberikan performa terbaik, baik dari segi kecepatan (tokens per second) maupun kualitas output (halusinasi). Penulis membahas strategi penentuan jumlah threads, alokasi context window, dan penyesuaian parameter sampling (temperature, top-p, top-k) untuk menstabilkan output. Studi kasus benchmark dilakukan pada dua lingkungan berbeda: laptop konsumen dengan offloading GPU parsial, dan Raspberry Pi (CPU-only). Hasil menunjukkan bahwa optimasi parameter yang tepat dapat meningkatkan efisiensi inferensi secara signifikan dan mengurangi tingkat halusinasi pada tugas ekstraksi data.
Keywords— llama.cpp, Optimasi Parameter, GPU Offloading, Context Window, Temperature, Benchmark, Raspberry Pi, Local LLM
I. PENDAHULUAN
Di artikel pertama seri ini, kita sudah membahas apa itu `llama.cpp` dan kenapa format GGUF itu literally menjadi penyelamat bagi kita yang tidak memiliki GPU seharga motor [1]. Namun, banyak teman-teman yang baru masuk ke dunia Local LLM langsung menjalankan command dasar seperti ini:
./llama-cli -m model-7b-q4_k_m.gguf -p "Halo"Dan hasilnya? Well, bisa jadi sangat lambat, memakan RAM dalam jumlah besar, atau jawabannya mengarang bebas (halusinasi) yang cukup parah. Mengapa hal ini bisa terjadi? Karena kita menggunakan default setting yang belum tentu cocok dengan spesifikasi hardware dan kebutuhan penggunaan (use case) kita [2].
Di tulisan ini, saya akan membagikan panduan lengkap untuk mengoptimasi parameter `llama.cpp`. Kita akan bedah cara memilih jumlah threads, mengatur context window, dan menyetel temperature agar output model menjadi tajam, akurat, dan tidak melenceng. Siapkan terminal kalian, let’s dive in!
II. LANDASAN TEORI: BEDAH PARAMETER
Sebelum kita melakukan benchmark, ada baiknya kita memahami dulu “The Holy Trinity” dari parameter inferensi llama.cpp.
A. Threads (`-t`)
Parameter ini menentukan berapa banyak thread CPU yang digunakan untuk komputasi.
– Aturan Emas: Jangan asal mengatur ke angka maksimal (misalnya, jika CPU memiliki 16 threads, jangan langsung set `-t 16`). Fitur Hyperthreading pada CPU modern seringkali justru menambah overhead dan memperlambat operasi matriks di `llama.cpp` [3].
– Best Practice: Atur `-t` sesuai dengan jumlah Physical Cores yang dimiliki. Jika perangkat memiliki 8 cores / 16 threads, gunakan `-t 8` atau maksimal `-t 10`.
B. Context Window (`-c`)
Ini adalah “memori jangka pendek” model. Parameter ini mengatur berapa banyak token (kata/karakter) yang dapat diingat oleh model dalam satu sesi.
– Trade-off: Context window yang besar = model bisa membaca dokumen yang panjang. Namun, penggunaan RAM akan melonjak drastis (secara kuadratik terhadap ukuran context) [4].
– Sweet Spot: Untuk kebutuhan chatting atau ringkasan biasa, `-c 2048` atau `-c 4096` sudah lebih dari cukup dan sangat ramah terhadap kapasitas RAM.
C. Parameter Sampling (Temperature, Top-p, Top-k)
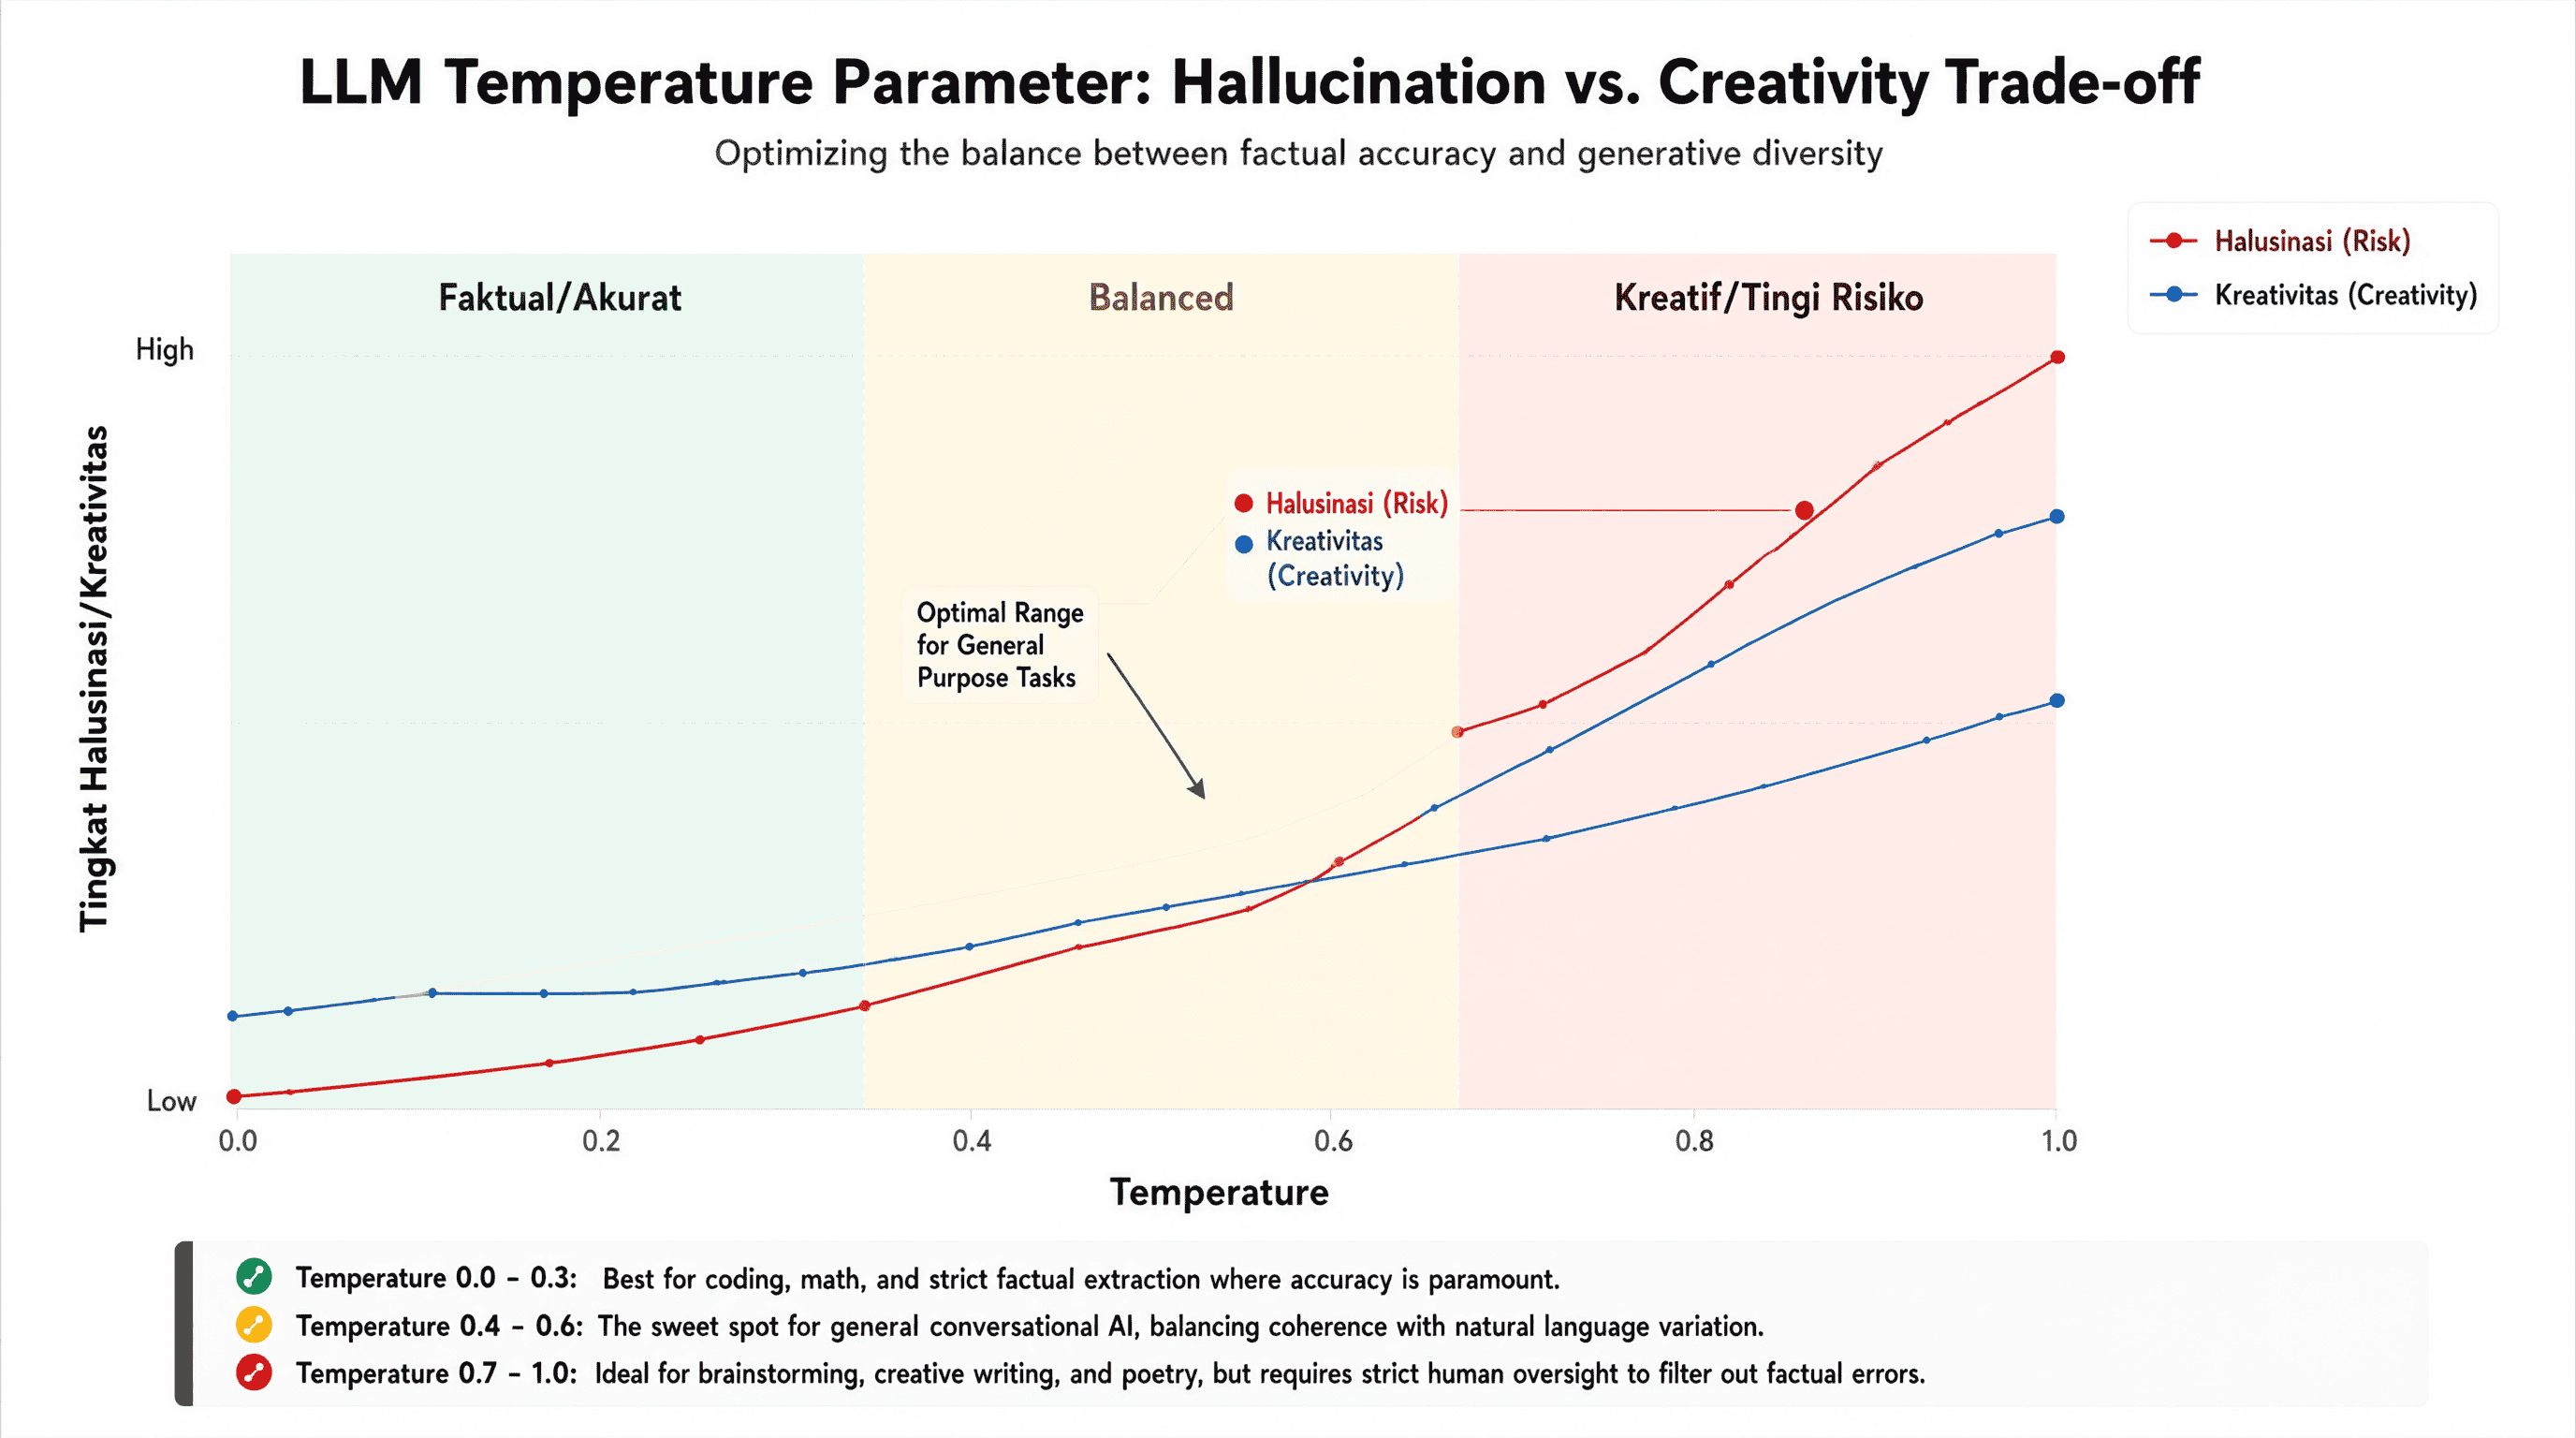
Parameter inilah yang mengatur keseimbangan antara “kreativitas” dan “fakta” dari output model [5]:
- Temperature (`–temp`): 0.0 = sangat deterministik (paling mungkin/faktual), 1.0 = kreatif/acak.
- Top-p (`–top-p`): Nucleus sampling. Memilih token dari persentase probabilitas teratas.
- Top-k (`-top-k`): Memilih token dari K token teratas.
III. HASIL DAN PEMBAHASAN (HANDS-ON)
Di bagian ini, kita akan mempraktikkan langsung command-nya untuk dua skenario hardware yang berbeda.
A. Skenario 1: Laptop/PC Konsumen (CPU + GPU Offloading)
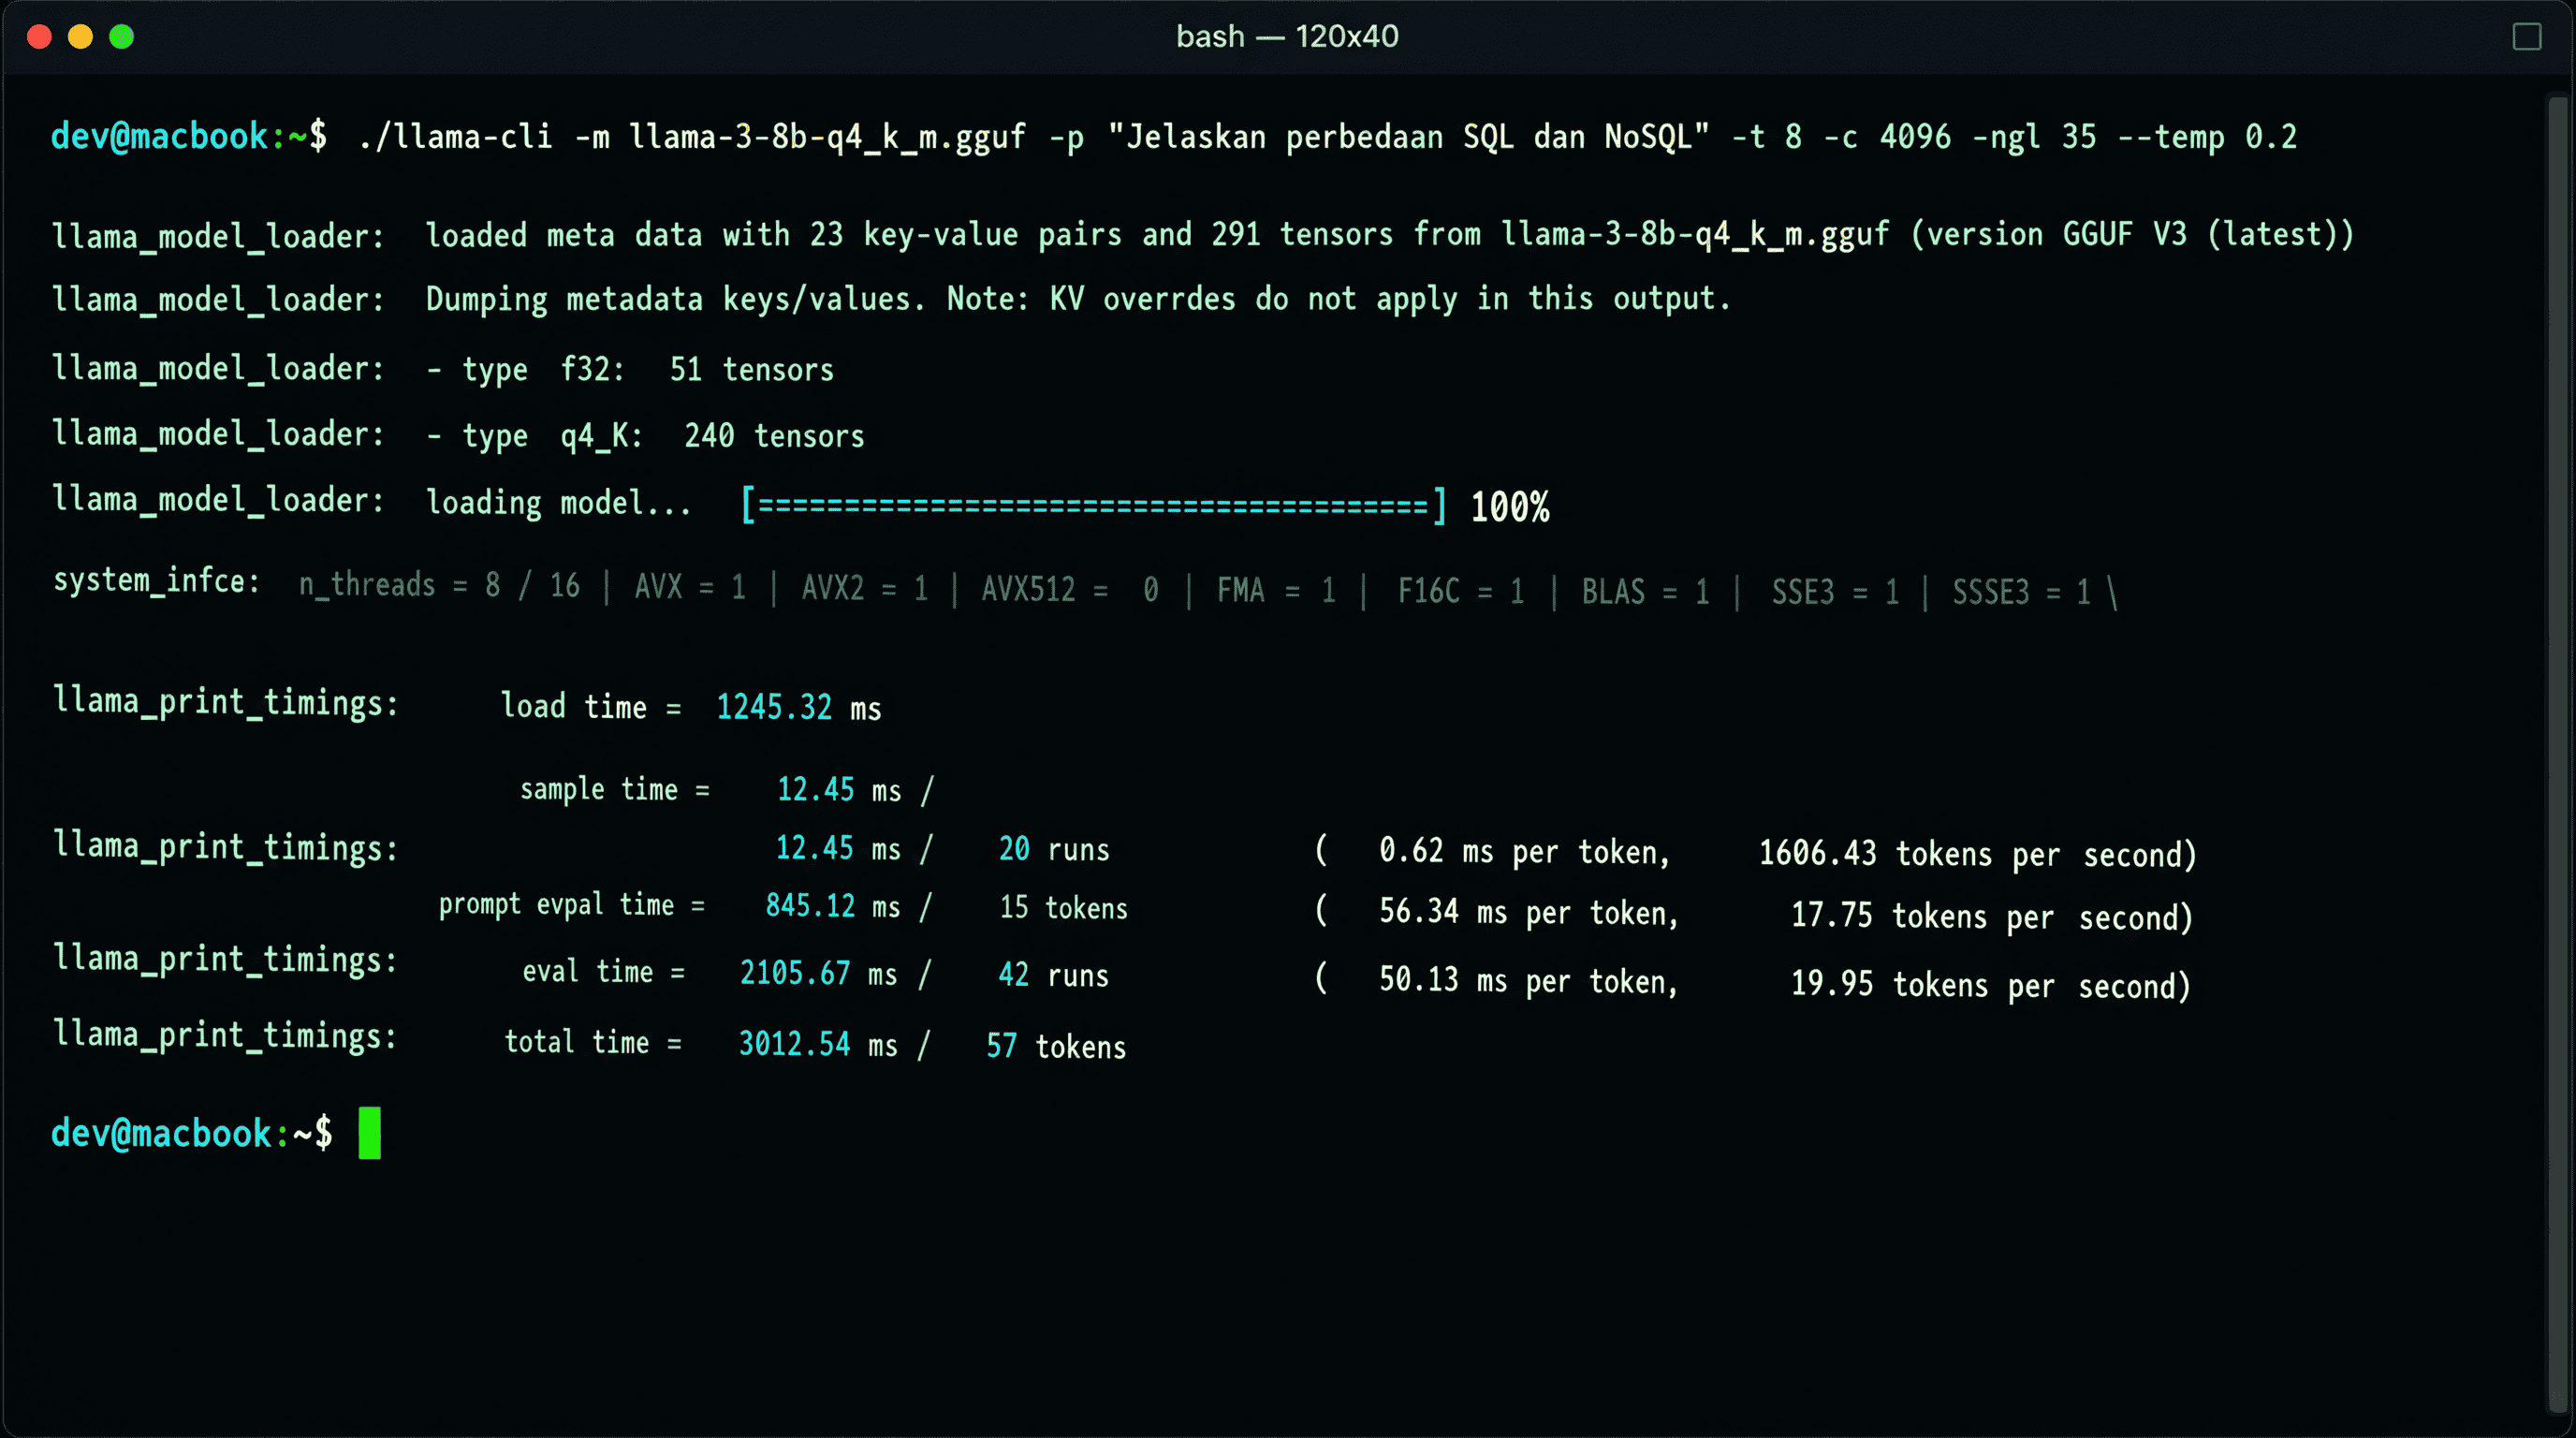
Jika kalian memiliki laptop dengan GPU diskrit (NVIDIA/AMD) atau iGPU modern (Apple Silicon/Intel Arc), kalian sangat disarankan untuk menggunakan fitur GPU Offloading (`-ngl`). Fitur ini akan memindahkan sebagian layer model ke GPU, yang membuat proses inferensi menjadi ngebut banget.
Command Optimasi:
./llama-cli -m llama-3-8b-q4_k_m.gguf \
  -p "Jelaskan perbedaan antara SQL dan NoSQL dalam 3 poin." \
  -t 8 \
  -c 4096 \
  -ngl 35 \
  --temp 0.2 \
  --top-p 0.9 \
  -top-k 40 \
--repeat-penalty 1.1Penjelasan Parameter:
Penjelasan Parameter:
-t 8: Asumsi laptop memiliki 8 physical cores.
-c 4096: Context window yang aman untuk laptop dengan RAM 16GB.
-ngl 35: *No-Graphic Layers*. Kita offload 35 layer model ke GPU. Jika kapasitas VRAM cukup besar, atur `-ngl 99` untuk memindahkan semua layer.
–temp 0.2 & –top-p 0.9: Kita buat model sedikit lebih “kaku” dan fokus. Sangat cocok untuk menanyakan fakta agar tidak mengarang.
–repeat-penalty 1.1: Mencegah model mengulang-ulang kalimat yang sama secara terus-menerus (looping).
B. Skenario 2: Raspberry Pi 4/5 (CPU Only, Low RAM)
Nah, ini adalah tantangan yang sebenarnya. Raspberry Pi (terutama varian RAM 4GB/8GB) tidak memiliki GPU yang bisa di-offload. Kita harus mengandalkan CPU saja dan sangat berhemat dalam penggunaan RAM.
Command Optimasi:
./llama-cli -m qwen2.5-1.5b-q4_k_m.gguf \
  -p "Buatkan resep nasi goreng sederhana." \
  -t 4 \
  -c 2048 \
  -b 512 \
  --temp 0.7 \
--top-p 0.95Penjelasan Parameter:
- Pemilihan Model: Saya menggunakan Qwen2.5 1.5B, bukan 8B. Di Raspberry Pi, model 8B akan berjalan sangat lambat (1-2 tokens per detik). Model 1.5B hingga 3B adalah sweet spot untuk SBC (Single Board Computer).
- `-t 4`: Raspberry Pi 4/5 memiliki 4 cores. Atur menjadi 4 threads.
- `-c 2048`: Menghemat RAM! Context 4096 di Raspberry Pi dengan RAM 4GB berisiko tinggi menyebabkan Out of Memory (OOM).
- `-b 512`: *Batch size*. Mengecilkan batch size membuat proses loading prompt sedikit lebih lama, namun sangat efektif mengurangi lonjakan memori (memory spike) saat awal dijalankan.
- `–temp 0.7`: Menaikkan suhu sedikit agar resep yang dihasilkan lebih variatif dan tidak kaku.
C. Mencegah Halusinasi (Stabilizing Output)
Halusinasi adalah musuh utama LLM. Jika kalian menggunakan Local LLM untuk ekstraksi data dari PDF atau penulisan kode, kalian pasti tidak ingin modelnya mengarang bebas.
Tips Anti-Halusinasi di llama.cpp:
- Turunkan Temperature: Atur `–temp` antara `0.1` hingga `0.3`.
- Gunakan System Prompt yang Tegas:** Gunakan flag `-sys` atau sisipkan instruksi di awal prompt. Contoh: “Jawab hanya berdasarkan konteks yang diberikan. Jika tidak tahu, katakan ‘Saya tidak tahu’.”
- Naikkan Repeat Penalty: Atur `–repeat-penalty` menjadi `1.15` atau `1.2` untuk memaksa model menggunakan kosakata yang lebih variatif.
IV. KESIMPULAN
Optimasi parameter di `llama.cpp` bukanlah konsep one-size-fits-all. Settingan yang membuat model berjalan sangat cepat di laptop gaming, belum tentu berjalan mulus di Raspberry Pi. Kuncinya terletak pada pemahaman terhadap spesifikasi hardware (Physical Cores, VRAM, RAM) dan tujuan penggunaan (use case: apakah butuh fakta yang akurat atau kreativitas).
Dengan menyetel `threads` sesuai physical cores, membatasi `context window` sesuai kapasitas RAM, dan mengunci `temperature` untuk tugas yang bersifat faktual, kalian bisa mendapatkan performa maksimal dari perangkat standar yang dimiliki.
Di artikel selanjutnya (Seri 1.3), kita akan naik level: Mengubah llama.cpp Menjadi Local API Server. Kita akan membuat model lokal kita dapat diakses melalui HTTP REST API, yang nantinya akan kita hubungkan dengan n8n. Stay tuned!
UCAPAN TERIMA KASIH
Shoutout khusus untuk Georgi Gerganov dan seluruh kontributor llama.cpp yang terus memperbarui codebase-nya secara konsisten. Juga untuk komunitas LocalLLaMA di Reddit dan Discord yang sering berbagi benchmark serta preset parameter terbaik. You guys are the real MVPs!
REFERENSI
[1] M. Artha, “Mengenal llama.cpp: Revolusi Menjalankan Large Language Model (LLM) di Perangkat Standar,” Artha.web.id Blog, Okt. 2026. [Online]. Available: https://artha.web.id
[2] G. Gerganov, “llama.cpp README: Command Line Arguments and Performance Tuning,” *GitHub*, 2026. [Online]. Available: https://github.com/ggerganov/llama.cpp
[3] Phoronix, “CPU Thread Count Impact on AI Inference Performance,” *Phoronix Test Suite*, 2025. [Online]. Available: https://www.phoronix.com
[4] T. Dao et al., “FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning,” *ICLR*, 2024. [Online]. Available: https://arxiv.org/abs/2307.08691
[5] A. Holtzman et al., “The Curious Case of Neural Text Degeneration,” ICLR, 2020. [Online]. Available: https://arxiv.org/abs/1904.09751