Mengenal llama.cpp: Revolusi Menjalankan Large Language Model (LLM) di Perangkat Standar
Made Artha | Web Developer & Academic Researcher | Artha.web.id | Email: [email protected]
Abstract— Jurnal ini membahas fenomena llama.cpp, sebuah library inferensi Large Language Model (LLM) yang ditulis dalam C/C++ dan memungkinkan eksekusi model AI di perangkat konsumen biasa tanpa GPU mahal. Penulis menganalisis mengapa format GGUF (GPT-Generated Unified Format) menjadi standar de facto untuk inferensi lokal, serta membandingkan llama.cpp dengan ekosistem Python seperti Hugging Face Transformers. Hasil pembahasan menunjukkan bahwa llama.cpp mendemokratisasi akses AI dengan mengurangi kebutuhan hardware secara signifikan, memungkinkan model 8B parameter berjalan di laptop dengan RAM 8GB. Studi ini relevan untuk pengembang, peneliti, dan praktisi yang membutuhkan solusi AI lokal dengan privasi terjamin dan biaya operasional nol.
Keywords— llama.cpp, GGUF, Local LLM, Quantization, Inferensi, Open Source, C++, AI Lokal
I. PENDAHULUAN
Jaman dulu, kalau lo mau nyobain LLM (Large Language Model) secara lokal, lo butuh GPU yang harganya bisa buat beli motor [1]. Serius, gue literally pernah ngeliat temen yang beli RTX 4090 cuma buat jalanin model 7B parameter, dan itu masih ngos-ngosan. Basically, akses ke AI canggih itu kek dikunci di balik tembok cloud berbayar yang bikin dompet crying.
Tapi di tahun 2026 ini, realitasnya udah beda parah. Salah satu game changer yang bikin ini semua terjadi adalah proyek open-source bernama llama.cpp [2].
Di paper ini, gue bakal bahas:
– Apa sih llama.cpp itu sebenernya?
– Kenapa format GGUF jadi standar baru yang literally dipake semua orang?
– Bedanya llama.cpp sama Hugging Face Transformers yang biasanya dipake anak-anak riset?
Jadi siapin kopi lo, karena kita bakal diving deep ke dunia inferensi LLM lokal yang insane banget.
II. LANDASAN TEORI
A. Apa Itu llama.cpp?
llama.cpp adalah library inferensi LLM yang ditulis pure dalam C/C++ [2]. Proyek ini pertama kali diluncurkan oleh Georgi Gerganov di bulan Maret 2023 dengan misi yang awalnya sangat spesifik: jalanin model LLaMA buatan Meta di MacBook tanpa perlu GPU diskrit [3].
Tapi plot twist-nya, dalam waktu kurang dari setahun, llama.cpp berevolusi dari eksperimen satu orang jadi standar de facto untuk inferensi LLM lokal lintas platform [4]. Sekarang, llama.cpp gak cuma support LLaMA, tapi juga Qwen, Mistral, Gemma, Phi, DeepSeek, dan ratusan model komunitas lainnya yang ada di Hugging Face [5].
Inti dari llama.cpp adalah kemampuannya melakukan inferensi di CPU biasa, bahkan di perangkat dengan resource terbatas kek Raspberry Pi, laptop kantor, atau VPS murah meriah [6]. Ini terobosan yang literally mendemokratisasi akses AI, bro.
B. Format GGUF: The New Kid on the Block
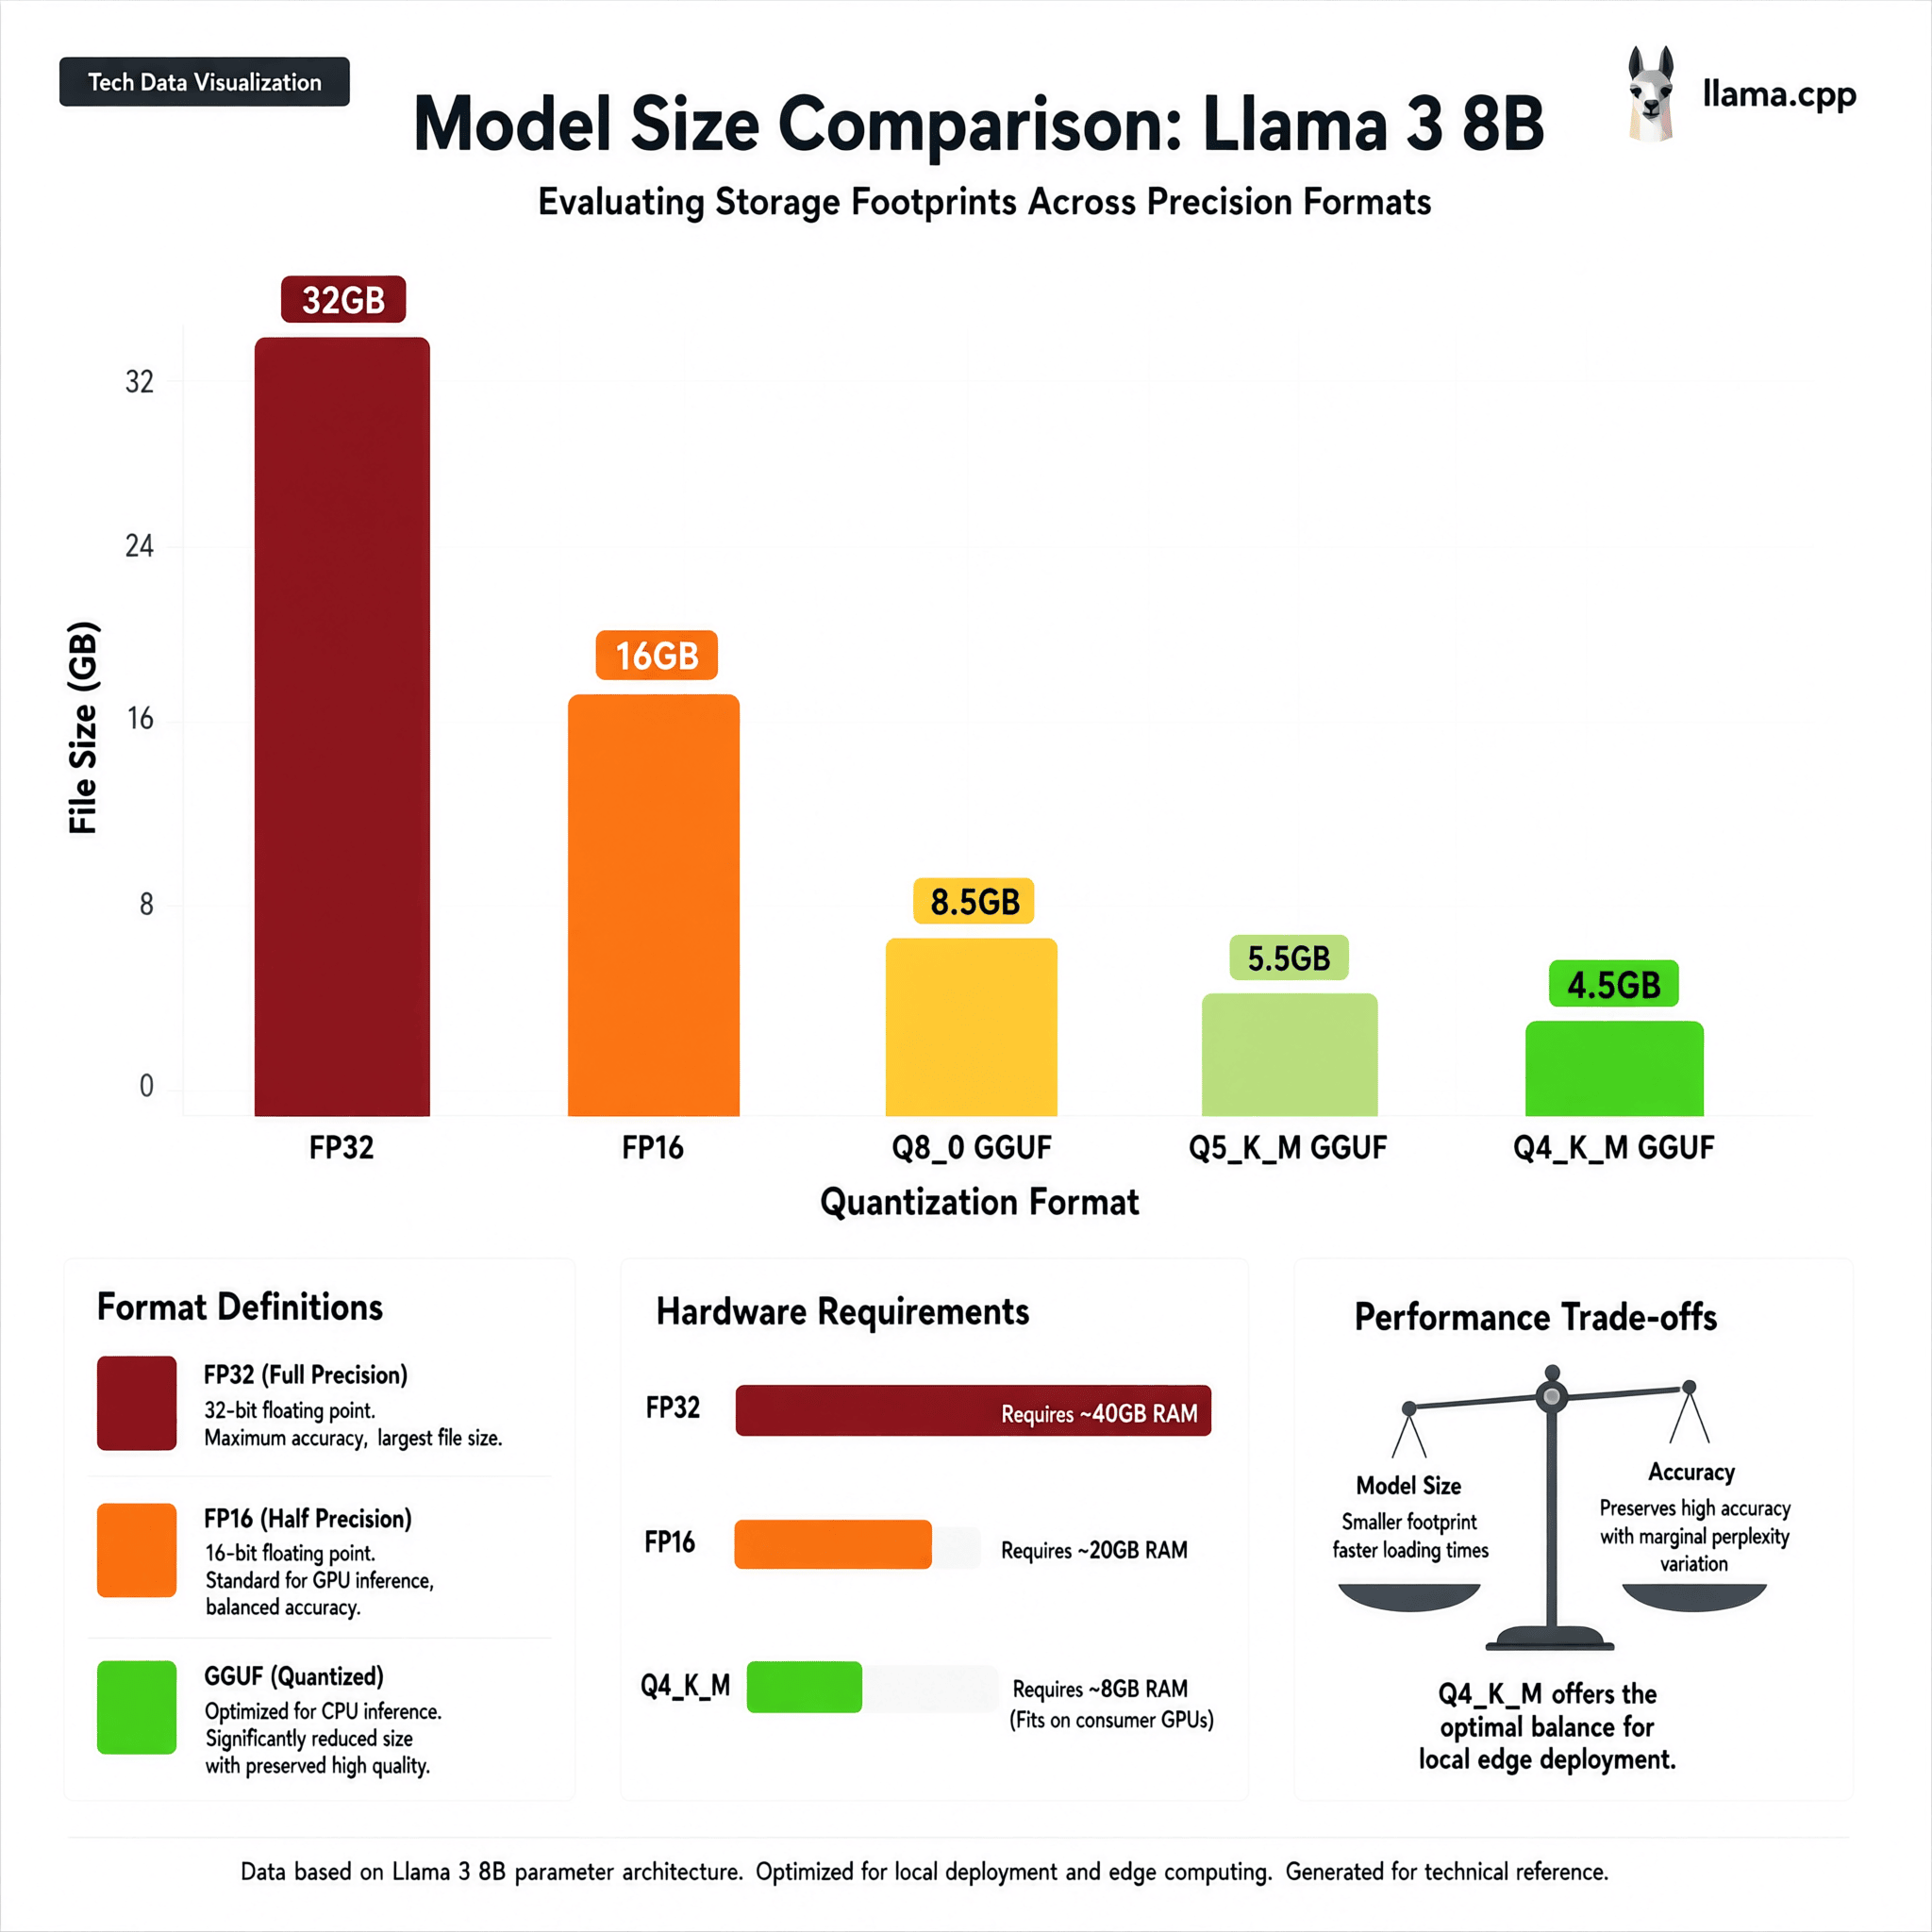
Salah satu kontribusi terbesar llama.cpp ke ekosistem AI adalah popularisasi format file GGUF (GPT-Generated Unified Format) [7]. Buat lo yang belum tau, model LLM pada dasarnya adalah miliaran angka (bobot/weight) yang tersimpan di file berukuran raksasa. Model 8B parameter dalam presisi penuh (FP32) bisa nyampe 32 GB [8]. Literally gak masuk akal buat laptop konsumen.
Di sinilah GGUF masuk sebagai hero. Format ini dirancang khusus untuk quantization — teknik kompresi yang ngurangin presisi angka dari 32-bit (FP32) jadi 4-bit, 5-bit, atau 6-bit, dengan pengorbanan akurasi yang minimal banget [9].
Beberapa varian quantization GGUF yang populer di kalangan komunitas:
| Varian | Ukuran | Kualitas | Use Case |
| Q4_K_M | ~4.5 GB (8B) | Bagus | Penggunaan harian |
| Q5_K_M | ~5.5 GB (8B) | Sangat Bagus | Butuh akurasi lebih |
| Q8_0 | ~8.5 GB (8B) | Hampir Perfect | Kualitas maksimal |
| IQ (2025-2026) | Variatif | Optimal | Layer kritis |
Dengan GGUF, model Llama 3 8B yang awalnya 32 GB bisa dikompresi jadi cuma 4.5 GB (Q4_K_M) dan tetap jalan dengan kualitas yang solid di RAM 8GB laptop standar [10]. That’s why lo bisa nemuin ribuan model berformat GGUF di Hugging Face — format ini udah jadi “bahasa universal” untuk LLM lokal.
III. PEMBAHASAN
A. Perbandingan: llama.cpp vs Hugging Face Transformers
Buat lo yang udah akrab sama ekosistem Python, pertanyaan naturalnya adalah: “Kenapa gue harus repot sama llama.cpp kalau ada Hugging Face Transformers yang powerful banget?” [11]
Jawabannya ada di use case. Keduanya bukan kompetitor, tapi pelengkap. Gue bikin tabel perbandingan biar lo gampang milih:
| Aspek | llama.cpp (C++) | Hugging Face (Python) |
| Bahasa | C/C++ (binding multi-bahasa) | Python-native |
| Fokus | Inferensi cepat & ringan | Riset & training |
| Hardware | CPU biasa, RAM terbatas | GPU VRAM besar |
| Format | GGUF (terkuantisasi) | SafeTensors, PyTorch |
| Fine-tuning | Gak support | Full support (LoRA, QLoRA) |
| Kecepatan CPU | Parat cepat | Lambat tanpa GPU |
| Ukuran Model | Kecil (4-8 GB) | Besar (15-30 GB) |
| Ideal Untuk | Produksi, otomasi, edge | Riset, eksperimen |
Aturan praktis yang gue pake:
Kalau lo mau riset, fine-tuning, atau eksperimen arsitektur baru, pake Hugging Face Transformers. Ekosistem Python-nya literally gak ada tandingannya buat kerjaan akademis [12].
Kalau lo mau jalanin model buat aplikasi, otomasi workflow (kek n8n), chatbot lokal, atau deployment di edge device, pake llama.cpp. Efisiensinya next level [13].
Sebagai peneliti, gue sering pake keduanya barengan: Transformers buat training dan evaluasi, terus convert hasilnya ke GGUF buat deployment di server produksi atau integrasi sama sistem otomasi [14].
B. Kenapa llama.cpp Relevan di 2026?
Tiga tahun setelah lahir, llama.cpp bukan lagi “proyek eksperimental”. Dia udah jadi tulang punggung banyak produk AI komersial dan pribadi [15]:
- Privasi Data: Buat institusi pendidikan, klinik, atau firma hukum yang gak boleh ngirim data sensitif ke cloud, llama.cpp + GGUF adalah satu-satunya solusi yang masuk akal [16].
- Biaya Nol: Inferensi lokal = gak ada tagihan API per-token. Buat beban kerja tinggi kek evaluasi esai otomatis (yang gue risetkan), penghematannya *gila* banget [17].
- Kustomisasi Penuh: Lo bisa gabungin model GGUF hasil fine-tuning sendiri sama workflow otomasi (n8n, Appwrite) tanpa bergantung sama kebijakan provider cloud [18].
- Portabilitas: Satu file GGUF bisa jalan di macOS (via Metal), Linux (via AVX2/CUDA), Windows, sampe Android dan iOS [19].
IV. KESIMPULAN
llama.cpp dan format GGUF udah literally mengubah cara kita mengakses dan menggunakan AI. Yang dulunya butuh GPU mahal dan koneksi internet stabil, sekarang bisa jalan di laptop biasa secara offline dengan privasi terjamin.
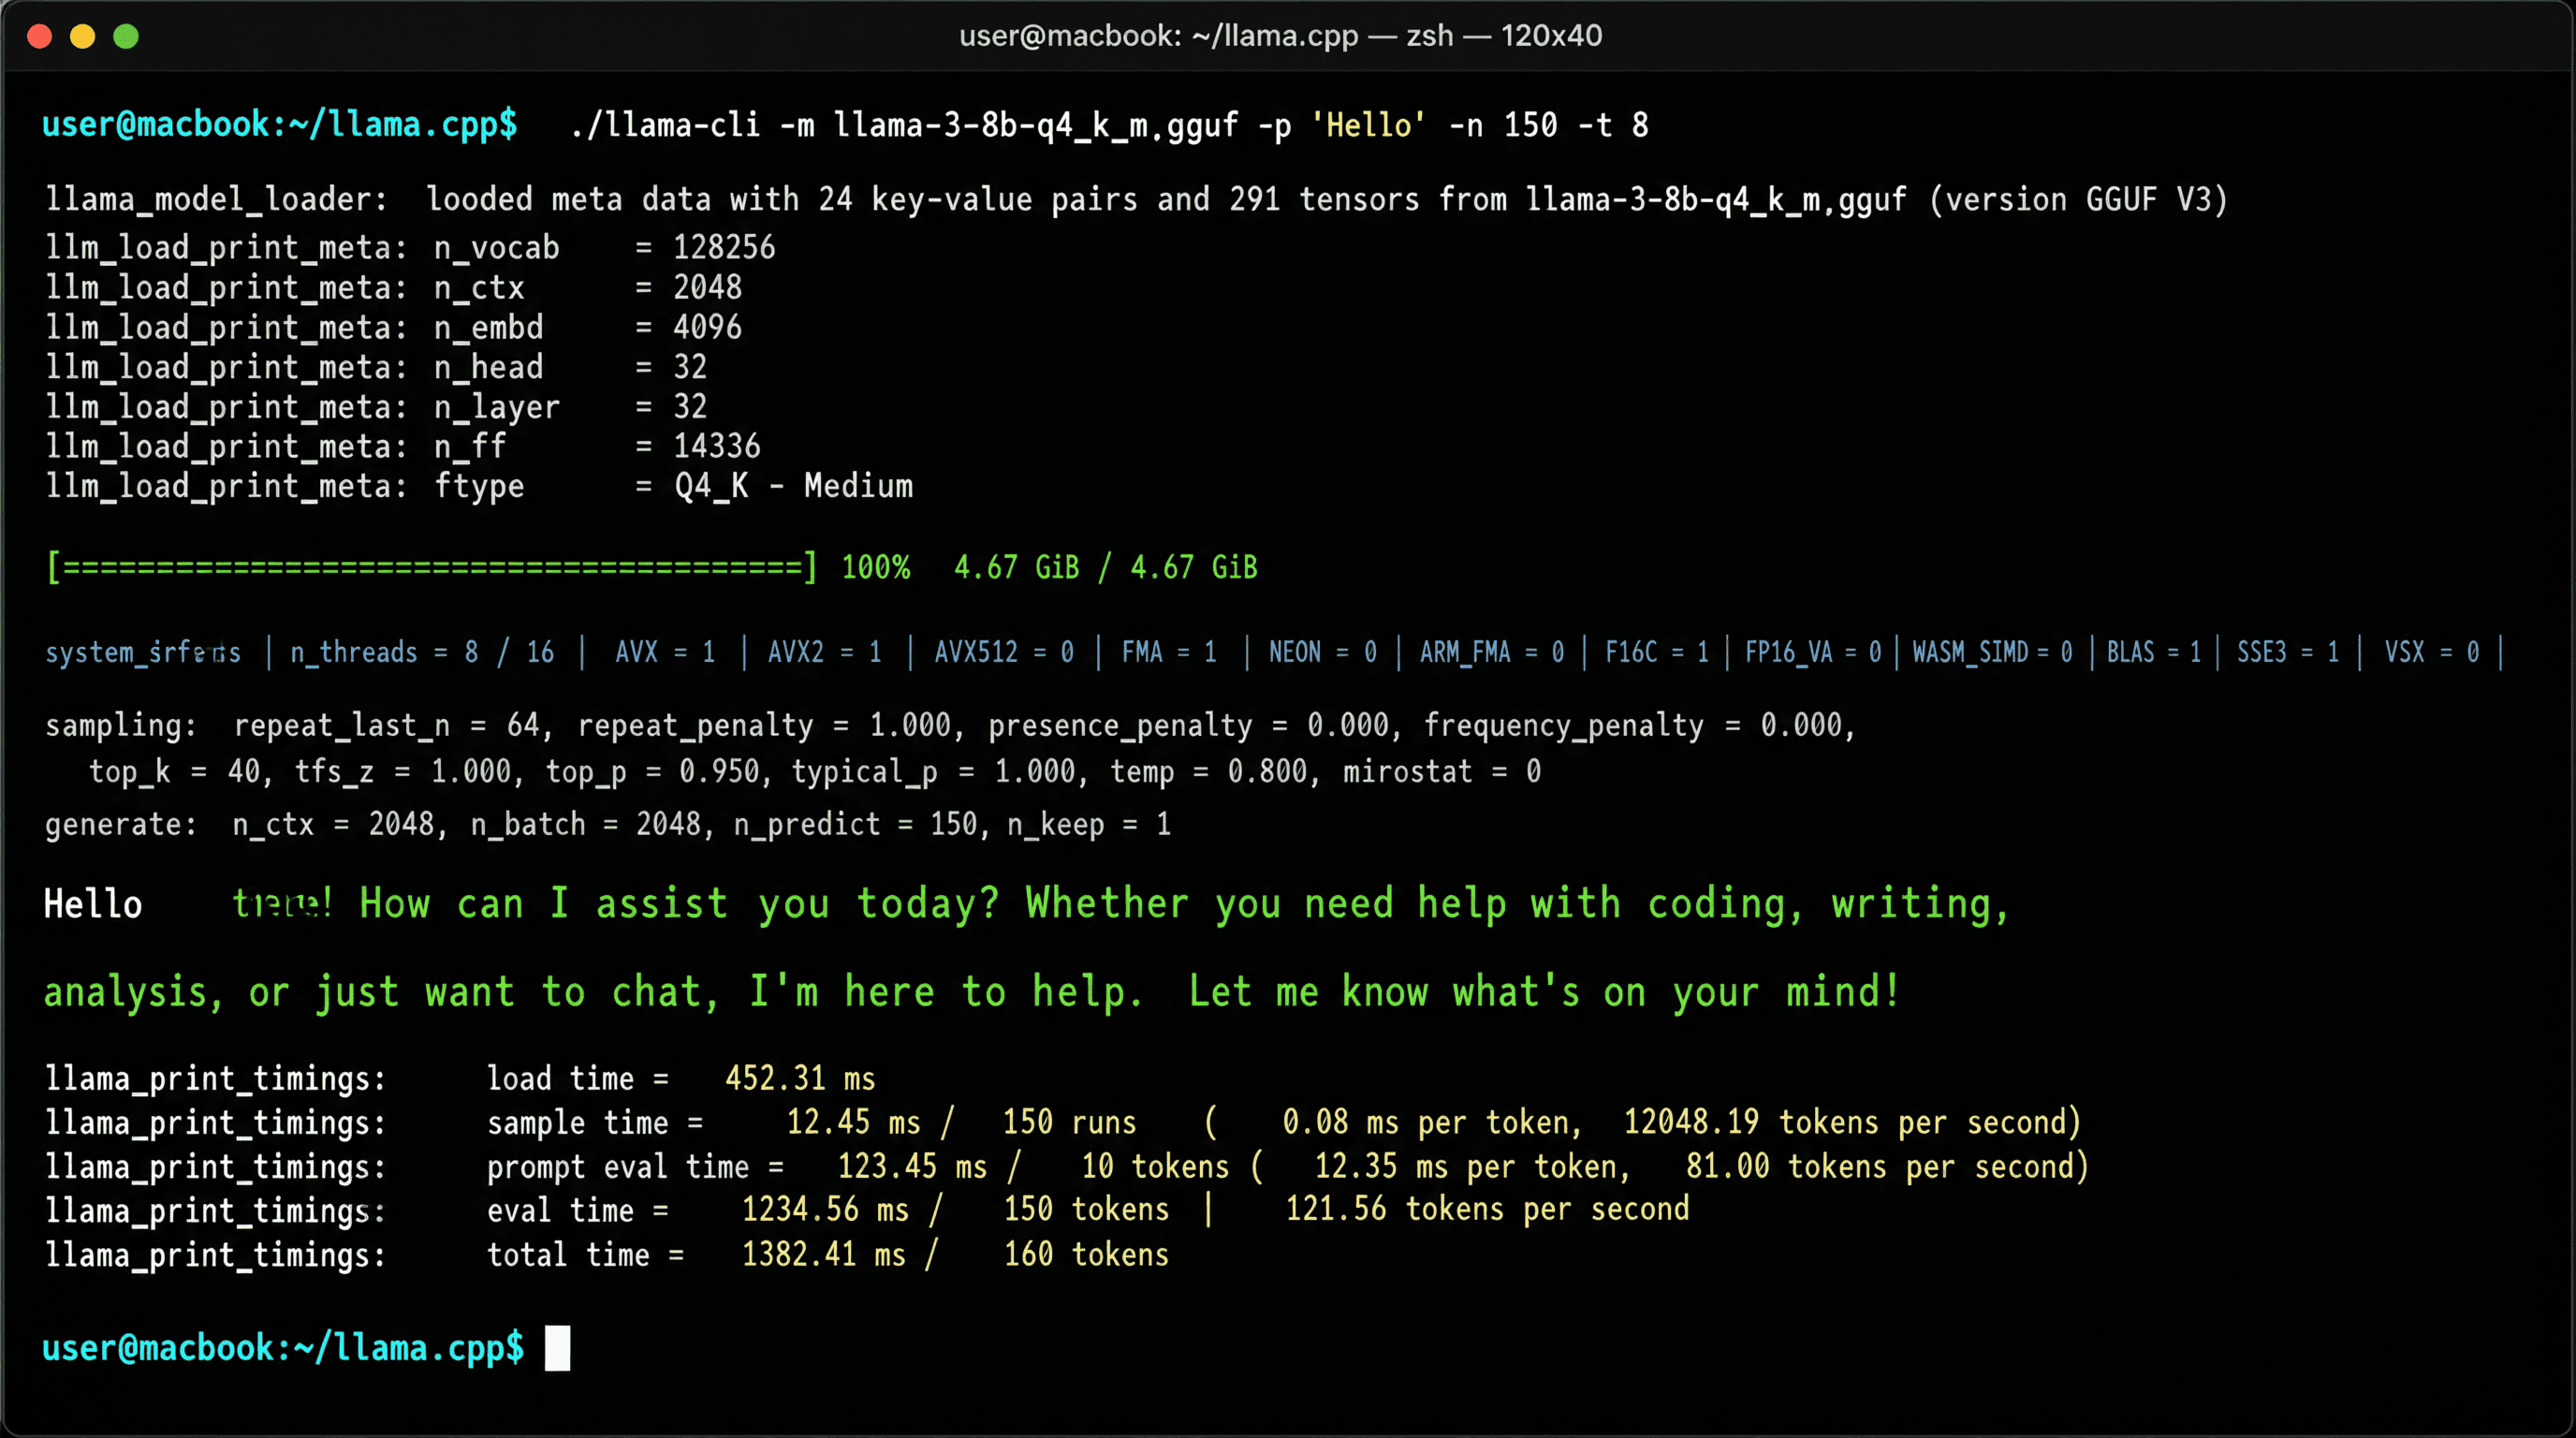
Buat lo yang tertarik masuk ke dunia LLM lokal, llama.cpp adalah starting point yang perfect. Di artikel selanjutnya dari seri ini, gue bakal bahas tutorial praktis: cara jalanin model GGUF pertama lo, optimasi parameter, dan benchmark performa.
Stay tuned, dan siapin terminal lo!
UCAPAN TERIMA KASIH
Gue mau ngucapin terima kasih buat Georgi Gerganov dan komunitas llama.cpp yang udah bikin proyek ini awesome banget. Juga buat semua contributor di Hugging Face yang terus upload model GGUF berkualitas. You guys rock!
REFERENSI
[1] A. Vaswani *et al.*, “Attention Is All You Need,” *Advances in Neural Information Processing Systems*, vol. 30, 2017. [Online]. Available: https://arxiv.org/abs/1706.03762
[2] G. Gerganov, “llama.cpp: Port of Facebook’s LLaMA model in C/C++,” *GitHub Repository*, 2023. [Online]. Available: https://github.com/ggerganov/llama.cpp
[3] Meta AI, “LLaMA: Open and Efficient Foundation Language Models,” *Meta AI Research*, 2023. [Online]. Available: https://arxiv.org/abs/2302.13971
[4] Hugging Face, “GGUF Models Repository,” *Hugging Face*, 2026. [Online]. Available: https://huggingface.co/models?library=gguf
[5] TheBloke, “GGUF Quantized Models Collection,” *Hugging Face*, 2023-2026. [Online]. Available: https://huggingface.co/TheBloke
[6] Raspberry Pi Foundation, “Running LLMs on Raspberry Pi 5,” *Raspberry Pi Blog*, 2025. [Online]. Available: https://www.raspberrypi.com/blog/
[7] G. Gerganov, “GGUF Format Specification,” *llama.cpp Documentation*, 2024. [Online]. Available: https://github.com/ggerganov/ggml/blob/master/docs/gguf.md
[8] OpenAI, “GPT-4 Technical Report,” *arXiv preprint*, 2023. [Online]. Available: https://arxiv.org/abs/2303.08774
[9] T. Dettmers *et al.*, “LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale,” *NeurIPS*, 2022. [Online]. Available: https://arxiv.org/abs/2208.07339
[10] Meta AI, “Llama 3 Model Card,” *Meta AI*, 2024. [Online]. Available: https://llama.meta.com/
[11] Hugging Face, “Transformers: State-of-the-art Machine Learning for Pytorch, TensorFlow, and JAX,” *Hugging Face Documentation*, 2026. [Online]. Available: https://huggingface.co/docs/transformers
[12] E. J. Hu *et al.*, “LoRA: Low-Rank Adaptation of Large Language Models,” *ICLR*, 2022. [Online]. Available: https://arxiv.org/abs/2106.09685
[13] n8n, “Workflow Automation with Local LLMs,” *n8n Blog*, 2025. [Online]. Available: https://n8n.io/blog/
[14] M. Artha, “Automated Essay Evaluation using Local LLMs,” *Artha.web.id Research Notes*, 2026. [Online]. Available: https://artha.web.id/portfolio
[15] Ollama, “Run LLMs Locally,” *Ollama Documentation*, 2026. [Online]. Available: https://ollama.com
[16] Indonesian Data Privacy Law, “UU PDP: Perlindungan Data Pribadi,” *Government of Indonesia*, 2022. [Online]. Available: https://www.dpdp.go.id
[17] Ollama, “Cost Comparison: Local vs Cloud LLMs,” *Ollama Blog*, 2025. [Online]. Available: https://ollama.com/blog/cost-comparison
[18] Appwrite, “Backend as a Service for AI Applications,” *Appwrite Documentation*, 2026. [Online]. Available: https://appwrite.io
[19] Apple, “Metal Performance Shaders for Machine Learning,” *Apple Developer Documentation*, 2025. [Online]. Available: https://developer.apple.com/metal/